왜 집현인가
학자들이 조사해 올리면 왕이 결정하던 집현전처럼, AI 직원들이 조사하고 만들고 서로 검증해 결과를 올리면 무엇을 받아들일지는 사람이 정합니다.
Technical PM
무엇을 만들지 정하고, 그것이 실제로 만들어졌는지 확인합니다.
7년
Bixby PM
2016.12 ~ 2023.07
50개 이상
3rd-party 캡슐
Bixby 파트너 서비스
40여 개
한국 CP 캡슐 전담
출시부터 개선, 출시 보류까지
약 60% → 90% 이상
한국 CP 발화 중 담당 캡슐 비중
2019년 4월에서 2020년 하반기로, 날씨 제외
5종
맡은 기기
Mobile, Watch, PC, Buds, Speaker
4회
최고 고과 EX
그룹장 추천 특별 고과 S 1회
Bixby 1.0 출시 전에 합류해 7년 동안 파트너 서비스와 모든 기기의 경험을 맡았습니다.
직접 기획하고 출시하거나 맡아 운영한 캡슐입니다. 출시부터 개선, 출시 보류까지 판단했습니다.
담당 캡슐이 차지한 한국 CP 발화 날씨 제외
담당 캡슐이 차지한 한국 CP 발화 비중이 2019년 4월 약 60%에서 2020년 하반기 90% 이상(날씨 제외)이 됐습니다. 사내 개발 CP 캡슐 40여 개를 넘겨받아 한국향 CP 캡슐 전체를 직접 맡았고, 음악 캡슐은 늘 최상위 사용량을 유지했습니다.
여러 기기가 함께 있을 때는 Multi Device Wake-up(한 기기만 깨어나게)과 Device Dispatch(기기를 지정해 말하면 그 기기가 실행하게)를 요구사항으로 정했습니다.
회사를 나와 창업과 고객사 DX를 거치며 현장의 일을 가까이에서 봤습니다.
그 일을 시스템으로 옮겼습니다.
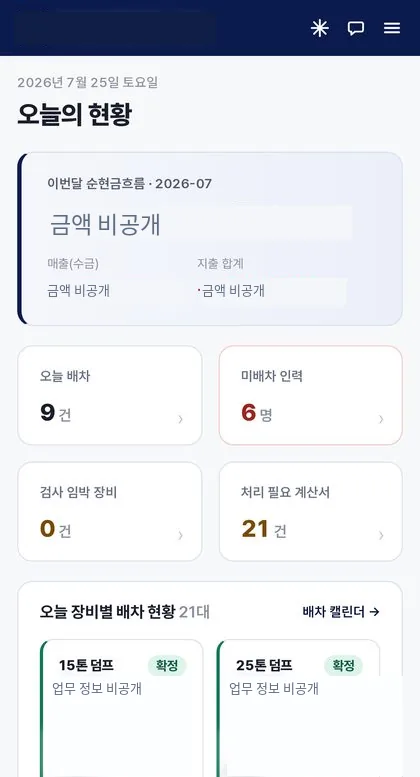
토목 건설 현장에 중장비와 기사를 보내는 고객사의 현장직과 사무직이 종이 달력과 카카오톡, 엑셀로 나눠 하던 일을 한 시스템으로 옮겼습니다.
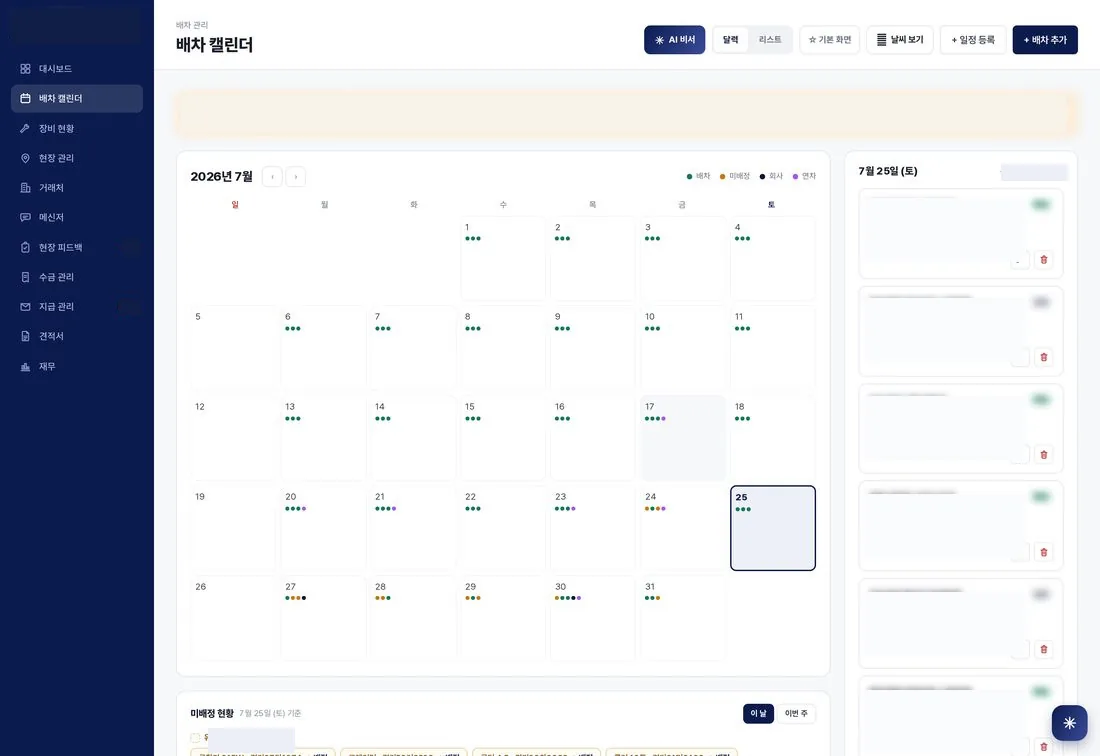
배차 캘린더. 종이 달력이 하던 일을 이 화면이 맡습니다.
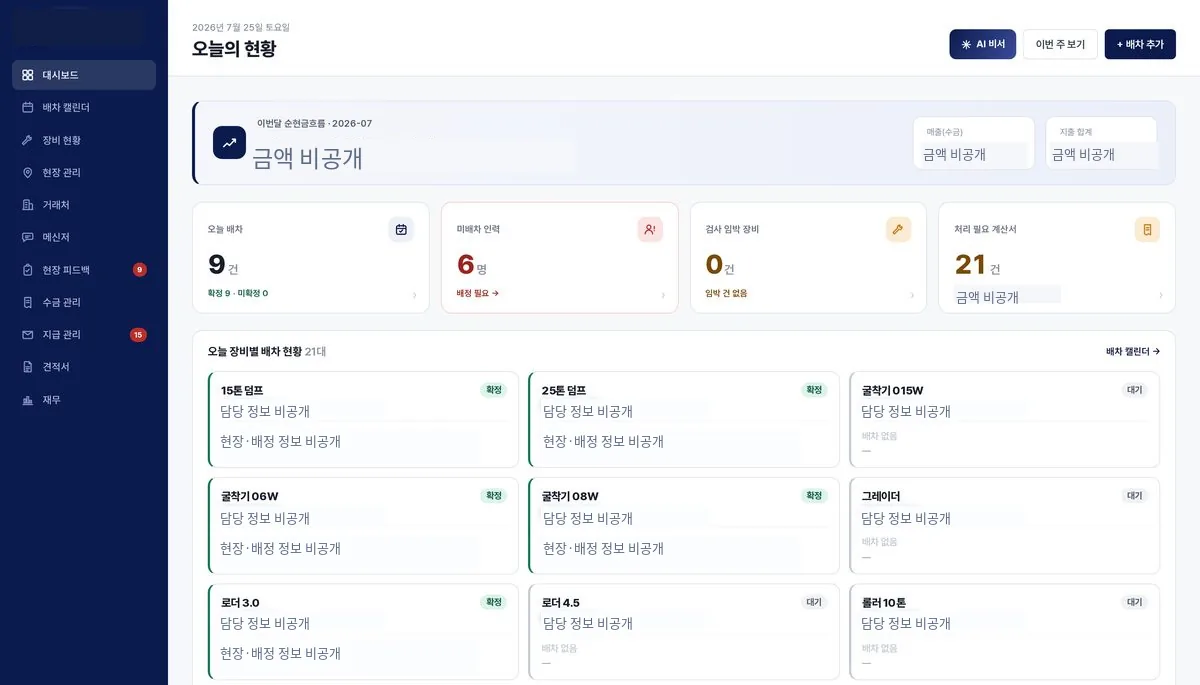
오늘의 현황. 금액과 거래처는 가렸습니다. 배차 한 건을 매출, 매입, 재무, 세무의 공통 원천으로 두었습니다.
현장 직원이 불편했던 일(종이 달력, 카카오톡 배차)과, 사무직이 여러 구독형 앱을 오가며 하던 업무(계산서, 수금, 지급, 재무)를 한 시스템에 모아 모든 업무를 한곳에서 관리하게 했습니다.
현업 인터뷰와 요구사항 정리에서 시작해 업무 모델과 시스템 구조를 설계하고, AI 에이전트를 지휘해 구현한 뒤 배포와 운영까지 맡았습니다.
AI와 여러 제품을 만들면서 "다 했습니다"라는 보고와 실제 결과가 다른 일을 자주 겪었습니다.
그 불편을 하나씩 모아 AI가 일하는 회사를 직접 만들었습니다.
만들고 싶은 것을 한 문장으로 맡기면 AI 직원들이 회의부터 전달까지 진행하고, 그 결과를 AI의 보고가 아닌 검사 기록으로 판정하는 제품입니다.
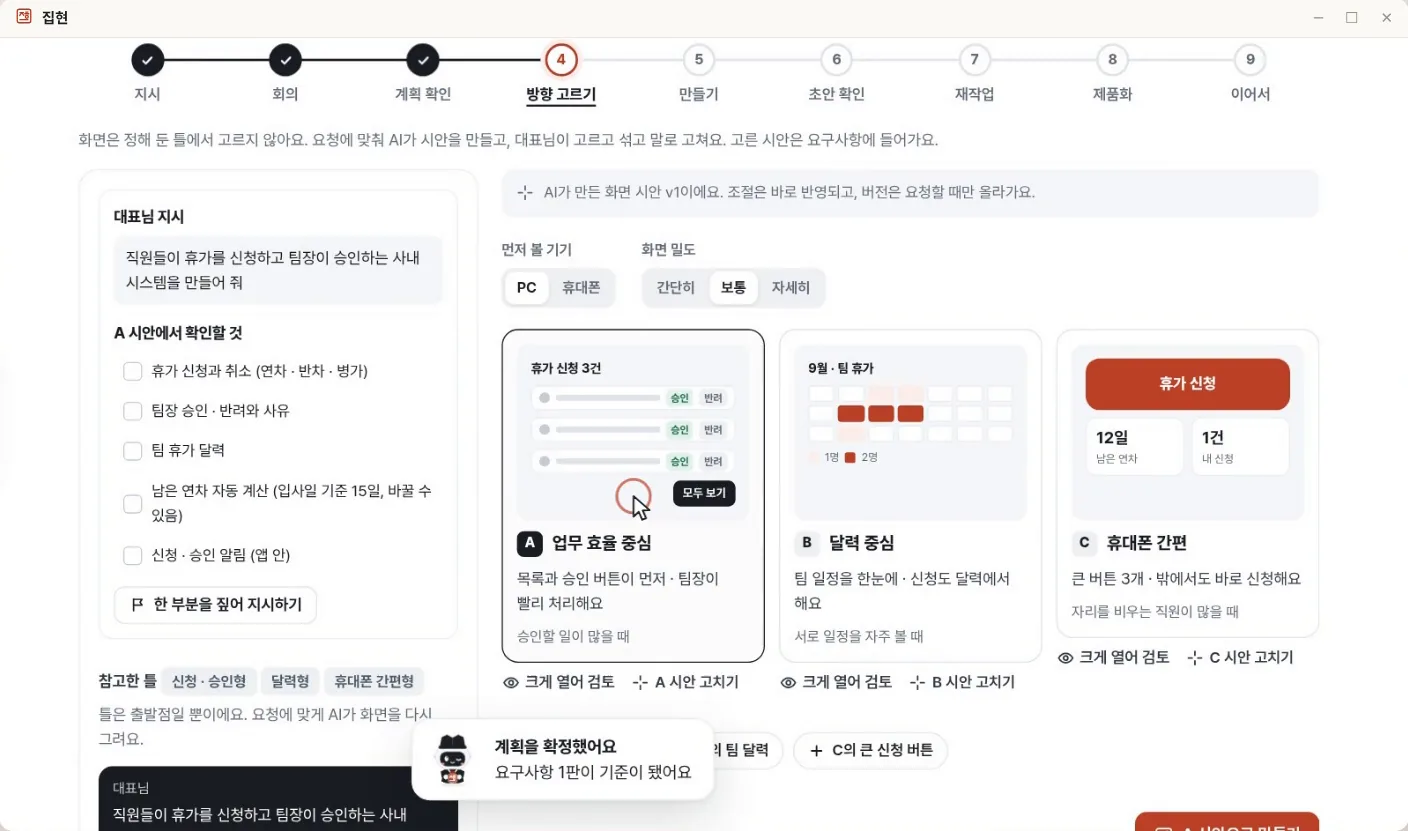
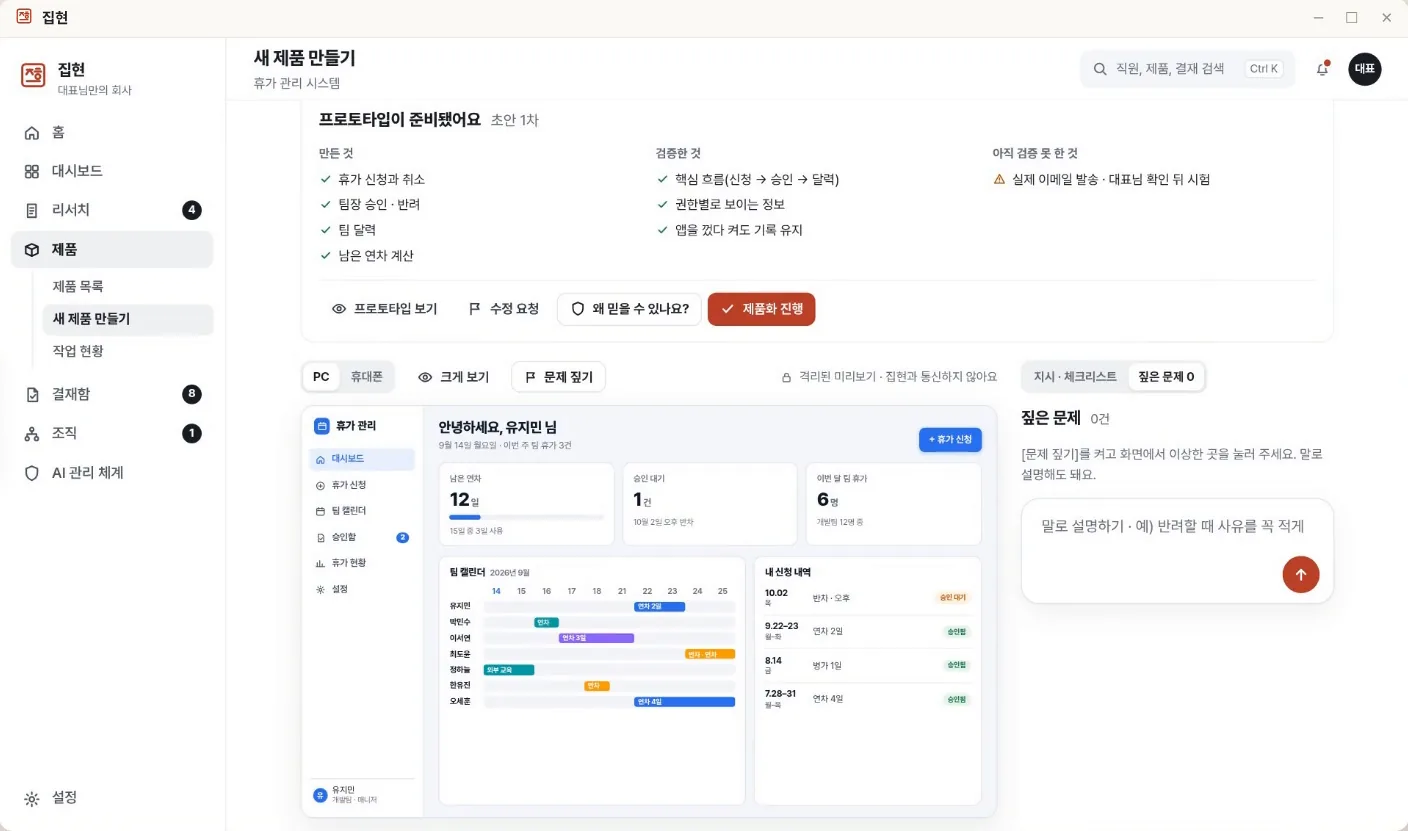
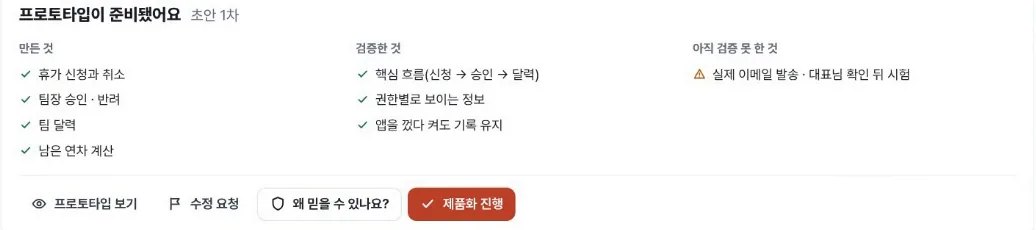
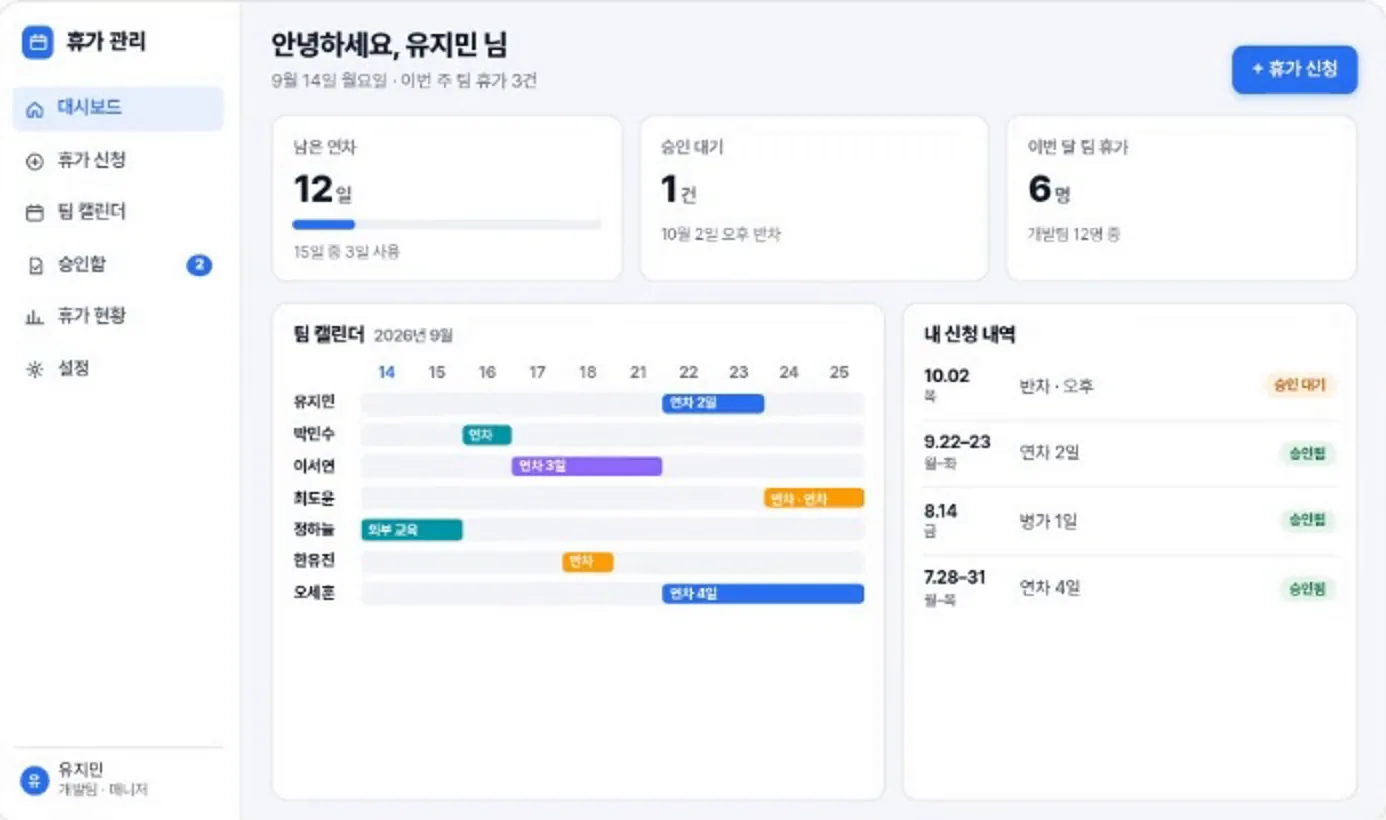
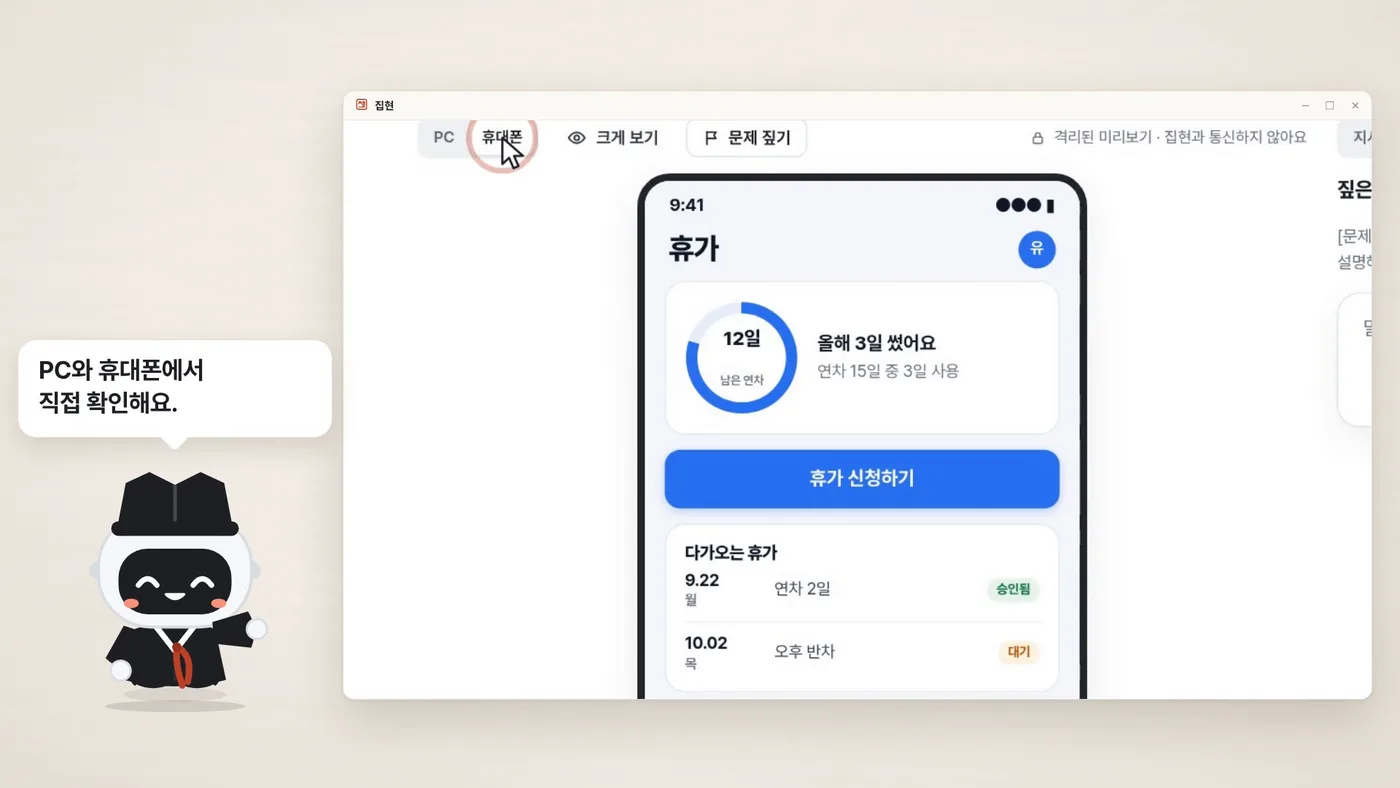
사람이 결정하는 단계
학자들이 조사해 올리면 왕이 결정하던 집현전처럼, AI 직원들이 조사하고 만들고 서로 검증해 결과를 올리면 무엇을 받아들일지는 사람이 정합니다.
이런 불편을 하나씩 해결할 장치를 모으다 보니 회사 모양이 됐습니다.
작업자에게는 결과를 확정할 권한이 없습니다. 검사가 실패하면 모델이 통과라고 해도 통과가 아니고, 아직 검증하지 못한 것은 따로 보여 줍니다.
AI 검색과 AI 판정자를 어디까지 믿을 수 있는지 공개 벤치마크로 직접 측정했고, 결과와 원자료를 모두 공개했습니다.
AI 판정자는 정답이 몇 번 보기에 있느냐에 따라 정확도가 크게 흔들렸습니다. 같은 문항에서 정답 위치만 바꿨는데 차이가 최대 약 62%p까지 났습니다.
판정 모델별로, 정답 위치(A~D)만 바꿨을 때 벌어진 정확도 차이
평가 도구 allenai/reward-bench에 이슈 4건과 PR 1건을 냈고, 그중 이슈 2건이 수정으로 이어졌습니다.
github.com/sixijsu77-hub/themis-judge-reliability한국어 문서 검색에서 BM25, 임베딩, 둘을 섞은 하이브리드 가운데 무엇이 나은지 공개 벤치마크 3종으로 쟀습니다. 결과를 보기 전에 가설부터 등록했고, 공개 리더보드 수치 7개를 다시 재현해 5개는 소수 다섯째 자리까지 맞췄습니다.
하이브리드 가중치
미리 세운 예측 0.2~0.4 실제로 가장 좋았던 값 0.8~0.9
예측이 틀렸지만 결과는 그대로 공개했습니다.
투자 이론을 배운 AI가 스스로 매매를 판단하게 만든 금융 도메인 실험입니다. 짧은 시험에서 좋아 보이던 결과가 긴 재검증에서 우연으로 드러난 뒤로는, 기능을 늘리기보다 검증 체계를 먼저 세웠습니다.
학습 한 세대에 걸리던 시간. 병목을 세 구간으로 나눠 재 보니 원인은 샘플링 I/O였습니다.
만들고 있습니다.
| Bixby | 기업 운영 시스템 | 집현 | THEMIS | MIMIR | NEIVY | |
|---|---|---|---|---|---|---|
| 제품 요구사항, 우선순위, 출시 | ||||||
| 파트너 서비스 연동과 여러 기기의 Voice UX | ||||||
| 현업 업무 분석과 데이터 모델 설계 | ||||||
| AI 적용 범위 판단과 모델 선택 | ||||||
| AI 실행 구조, 권한, 검증 설계 | ||||||
| AI 에이전트 개발 조직 운영 | ||||||
| 평가 설계와 외부 기준 검증 | ||||||
| 구축, 배포, 운영 |